はじめに:Physical AIのよくある誤解
近年、AI技術の発展は目覚ましく、大規模言語モデル(LLM)がデジタル空間のあらゆる業務を効率化しつつあります。その次なるフロンティアとして、世界中の投資家や技術者から熱い視線を浴びているのが「Physical AI(フィジカルAI)」です。
私たちヒューマノイド開発の最前線に立つスタートアップとして、Physical AIに興味を持つ方々と頻繁にお話ししていますが、実業家や産業の現場の方々の中には、「言葉で命令できて、何でも頼めばできるAIロボット」のようなイメージを持たれている方が多くいらっしゃいます。
このイメージはどれほど本当なのでしょうか?そもそもPhysical AIとはなんなのでしょうか?
この問いは非常に本質的です。世間ではPhysical AIという言葉が先行し、万能なヒューマノイドがすべての労働を代替するような未来図ばかりが注目されがちですが、実産業に実装するためには、技術の「現在地」を正しく解像度高く理解する必要があります。
本連載では全3回にわたり、ヒューマノイドスタートアップの視点からPhysical AIの真の価値と実用性、そして乗り越えるべき壁について紐解いていきます。第1回となる本記事では、まず「Physical AI」ならびに専門領域で重視される「Embodied AI(身体性AI)」の定義を整理し、それらを構成する技術マップを俯瞰します。
「Physical AI」と「Embodied AI」の定義と境界線
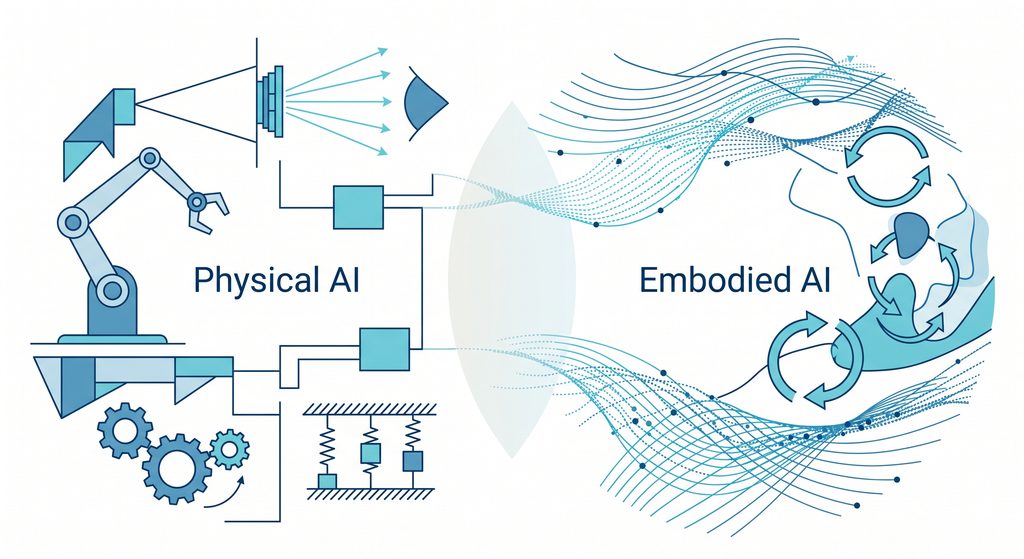
現在、メディアやビジネスの現場では「Physical AI」という言葉が広く使われていますが、ロボティクスや人工知能の学術分野においては「Embodied AI(身体性AI)」という概念がより重要な意味を持っています。まずはこの2つの言葉の解釈を整理します。
Physical AI(物理AI):世間一般におけるマジョリティな解釈
Physical AIは、ソフトウェアの世界(デジタル空間)に留まっていたAIが、センサー(目や耳)とアクチュエーター(筋肉)を持ち、現実の物理世界に直接的な変化をもたらすシステム全般を指す言葉として広く認知されています。自動運転車から、アーム型の産業用ロボット、ドローン、そしてヒューマノイドまで、物理的な形を持つAIシステムを総称する、やや広義でビジネスライクなバズワードとしての側面を持ち合わせています。一方で、マーケティング的な文脈で用いられるPhysical AIという言葉には、この言葉が登場する以前から存在していた技術が多く含まれています。技術者や研究者の間では、既存の技術領域と区別するために特に大規模なニューラルネットワークでロボットの認識・計画・行動を統合的に扱うアプローチのみをPhysical AIと呼ぶ狭義の使い方をする場合もあります。
Embodied AI(身体性AI):学術的・思想的なアプローチ
一方、一部の技術者や研究者がより好んで使うのがEmbodied AIです。これは単に「AIが物理的な体を持った」という状態を指すのではなく、「知能というものは、身体を通じて物理環境と相互作用(インタラクション)することでのみ獲得される」という認知科学のアプローチに基づいています。
この概念の重要性を歴史的に裏付けるのが、MITのロボット工学者であるロドニー・ブルックスが1990年に発表した著名な論文『Elephants Don’t Play Chess1(象はチェスをしない)』です。ブルックスは同論文内で、複雑な世界を頭脳(コンピュータ)の中だけで完全にシミュレーションすることは不可能であり、「世界そのものが、世界についての最良のモデルである(The world is its own best model)」と主張しました。
つまり、Embodied AIの考え方では、AIの脳(計算機)だけを賢くしても不十分であり、ロボットが実際に自分の「手」でモノを掴み、重さや摩擦、滑りやすさを感じ、失敗しながら学習していく「身体を通じた経験」のループこそが知能の源泉であると定義しているのです。
このEmbodied AIの考え方の発端はかなり前になりますが、近年においてもそれを支持する著名な研究者が多くいます。例えば、深層学習の発展に大きく貢献したアメリカの著名な人工知能研究者であるフェイフェイ・リは身体性を中心に据えたロボティクス研究を近年展開しています。
技術的視点:Physical AI/ Embodied AIを構成する技術マップ
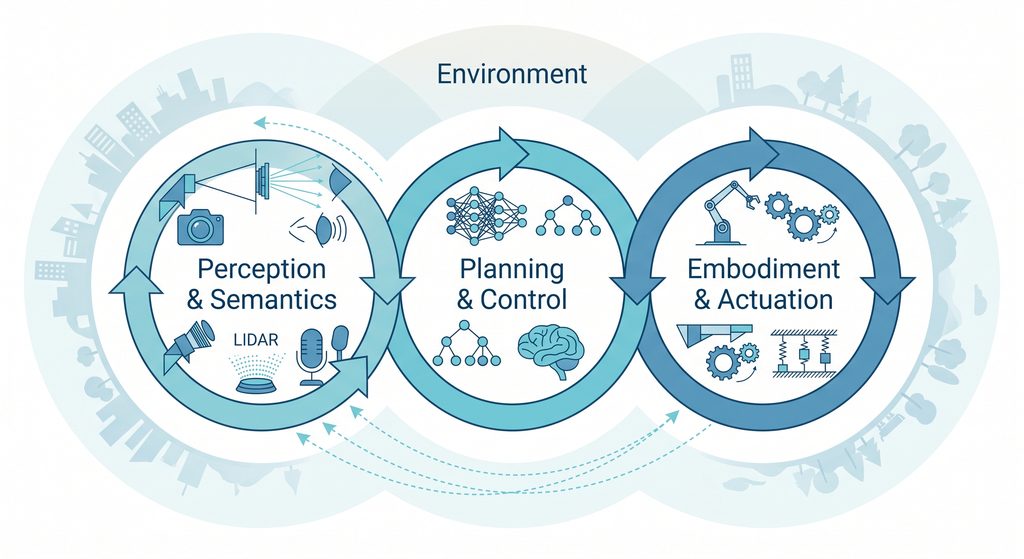
では、これらの概念は具体的にどのような技術スタックによって構成されているのでしょうか。単なる「カメラとモーター」の組み合わせから、AIが真の意味で物理世界を理解し操作するレベルへと進化するためには、以下の3つの技術領域の統合(ループ)が不可欠です。
認識と意味理解(Perception & Semantics)
従来のロボットは、カメラで対象物の「形」や「座標」を捉えることはできても、それが「何の意味を持つのか」を理解していませんでした。近年、ここに言語モデルを融合させたVision-Language-Action(VLA)モデルがブレイクスルーを起こしています。 例えば、Google DeepMindが2023年に発表した論文『RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control』では、Web上の膨大な画像とテキストで学習したモデルをロボットの制御に直接転移させる技術が示されました。これにより、ロボットに「赤いリンゴをゴミ箱に捨てて」と指示した場合、事前学習にない環境であっても、推論によってリンゴを認識し、自律的にタスクを実行することが可能になりつつあります。
学習と意思決定(Planning & Control)
現実世界はカオスであり、工場のようにすべてが計算通りに配置されているわけではありません。そのため、AIは未知の状況でも適切な動作を計画(Planning)する必要があります。ここで用いられるのが、強化学習(Reinforcement Learning)や模倣学習(Imitation Learning)です。 しかし、現実世界で何百万回もロボットを動かして学習させるのはコストと時間の面で非現実的です。そこで、物理演算を極めてリアルに再現したデジタルツイン(シミュレーション環境)内で数千万回の試行錯誤を行わせ、その学習結果を現実のロボットに移植する「Sim-to-Real(シミュレーションから現実への転移)」技術が、現在の開発の主戦場となっています。
身体と駆動系(Embodiment & Actuation)
AIからの高度な指令を、物理世界の「力」として正確に出力するハードウェア側の技術です。単にモーターを動かすだけでなく、人間のように力加減を調整するインピーダンス制御や、接触時の安全性を担保する柔らかい素材(ソフトロボティクス)、さらには触覚センサーによる微細なフィードバック技術が含まれます。優れた「脳(モデル)」があっても、それを表現する「身体(ハードウェア)」が未熟であれば、物理世界でのタスクは完遂できません。
以上の技術領域の関連性は一方通行ではなく、「環境を認識し」→「行動を決定し」→「身体を動かし」→「その結果生じた物理的変化を再びセンサーで学習する」という絶え間ないループを描いています。このループをいかに高速かつ高精度に回せるかが、技術的な優位性に直結します。Physical AIが近年話題になり始めた背景には、AIという言葉で強調されがちな学習と意思決定だけではなく、すべての領域における技術の進歩があります2。
私たちの立ち位置と開発思想
ここまで「Physical AI」と「Embodied AI」の定義、そしてそれらを支える技術マップについて解説してきました。
私たちヒューマノイドスタートアップとしてのスタンスを明確にすると、世間の皆様に技術のインパクトを広くお伝えする文脈においては、最も認知され、期待を集めている「Physical AI」という言葉(多数決の定義)を歓迎し、使用していきます。
留意したい点として、Physical AIの定義は未だ流動的です。私たちは特定の技術領域を指す流行語とそれが指す意味の変化にとらわれず、課題解決の望ましい形を模索する姿勢を持ち続けることをポリシーとしています。
では、Physical AIの潮流に乗って開発される次世代のロボットは、実際の産業の「どこ」で導入され、どのような課題を解決するのでしょうか。次回では、投資家や実業家の皆様が最も関心を寄せる「産業実装における実用ドメイン(ユースケース)」について、具体的な解像度を持ってお話しします。
- Elephants Don’t Play Chess | Elsevier ↩︎
- 近年に至るまでの技術の進歩については以前の特集「なぜ今,ヒューマノイドなのか ― 技術進化史の視点から」にてより詳細を紹介しています。第1回はこちらから:なぜ今,ヒューマノイドなのか ― 技術進化史の視点から|第1回:下半身制御 – HUMANOID INSIGHTS ↩︎